Eine umfassende Lösung für das Deployment von Large Language Models (LLMs) auf NVIDIA Tesla V100 GPUs in der HAW Hamburg Informatik Compute Cloud (ICC).
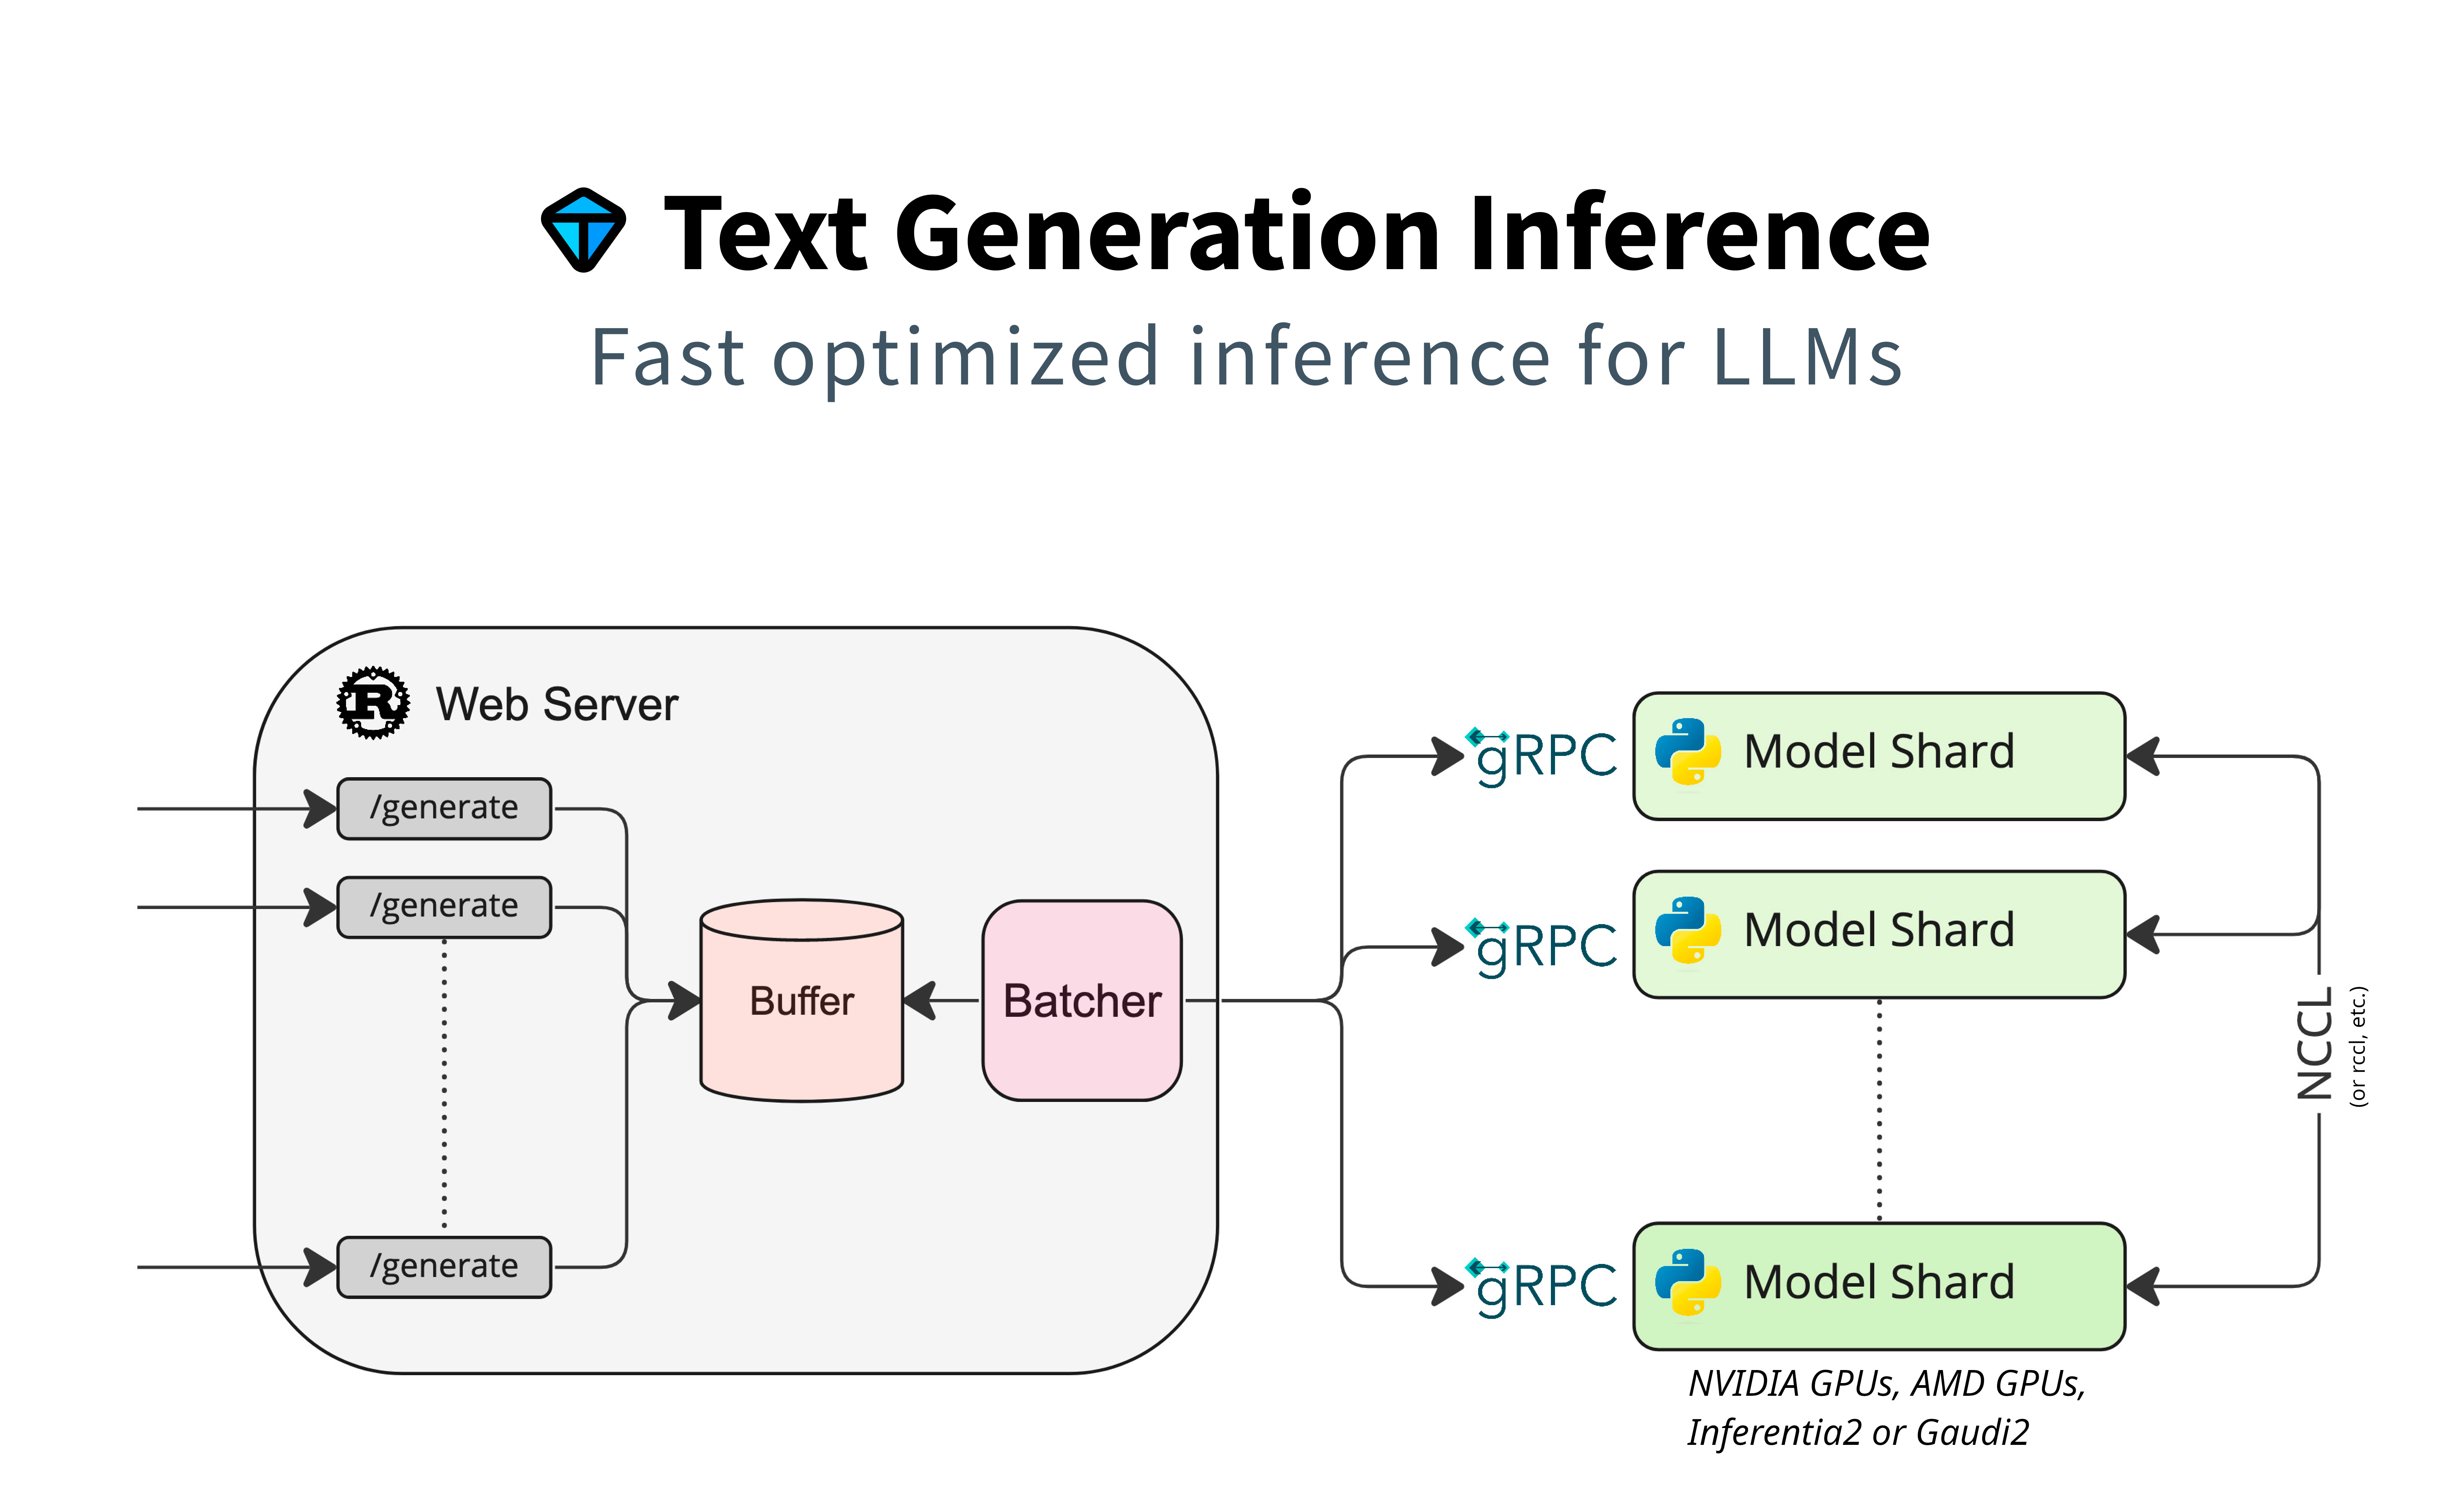
- V100-optimierte Konfiguration für NVIDIA Tesla V100 GPUs
- Zwei Inference-Engines: Text Generation Inference (TGI) und vLLM
- Multi-GPU-Unterstützung mit bis zu 4x V100 GPUs im Sharded-Modus (TGI) oder Tensor-Parallel-Modus (vLLM)
- OpenAI-kompatible REST API für einfache Integration
- Benutzerfreundliche WebUI für Chat-Interaktionen
- Unterstützung für zahlreiche Modelle: Mistral, Llama, Gemma, Phi, etc.
- Speicheroptimierungen: AWQ/GPTQ Quantisierung, optimierte Kontextlängen
- HAW Hamburg infw-Account mit ICC-Zugang
- kubectl-Client auf Ihrem lokalen System
- VPN-Verbindung zum HAW-Netz (bei Remote-Zugriff)
# Repository klonen
git clone https://github.com/scimbe/icc-Inference-deployment.git
cd icc-Inference-deployment

# Berechtigung setzen
chmod +x scripts/*.sh
chmod +x *.sh

# ICC-Login durchführen (einmalig)
./scripts/icc-login.sh

# Deployment starten (interaktiver Modus)
./deploy-v100.sh
Nach dem Deployment können Sie die WebUI unter http://localhost:3000 und die API unter http://localhost:8000 erreichen.
# 1. V100-optimierte Konfiguration kopieren
cp configs/config.v100.sh configs/config.sh

# 2. Konfiguration anpassen (wichtig!)
#    - NAMESPACE auf Ihre w-Kennung + "-default" setzen
#    - Modell und GPU-Anzahl wählen
#    - ENGINE_TYPE auf "tgi" oder "vllm" setzen (je nach Bedarf)
nano configs/config.sh

# 3. TGI mit V100-Optimierungen deployen
./scripts/deploy-tgi-v100.sh

# 4. ODER: vLLM deployen (empfohlen für bestimmte Anwendungsfälle)
./scripts/deploy-vllm-v100.sh

# 5. Web-Oberfläche installieren (nur für vllm)
./scripts/deploy-webui.sh

# 6. Zugriff einrichten
./scripts/port-forward.sh| Feature | TGI | vLLM |
|---|---|---|
| Performance | Gut für 1-7B Modelle | Bessere Latenz, besonders bei >7B Modellen |
| Speichereffizienz | Standard-Inferenz | Optimiert durch PagedAttention |
| Multi-GPU | Sharded-Modus | Tensor-Parallel-Modus |
| Quantisierung | AWQ, GPTQ | AWQ, GPTQ, GGUF |
| Batchverarbeitung | Gut | Sehr gut (höherer Durchsatz) |
| WebUI-Integration | Vollständig | Vollständig |
| V100-Kompatibilität | Sehr gut | Gut (erfordert ggf. zusätzliche Parameter) |
Wann welche Engine verwenden?
- TGI: Einfachere Konfiguration, sehr stabil, bessere Unterstützung für MoE-Modelle (Mixtral)
- vLLM: Höherer Durchsatz, geringere Latenz, besser für Anwendungen mit vielen gleichzeitigen Anfragen
| Modellgröße | GPU-Setup | Empfohlene Konfiguration | Beispielmodelle |
|---|---|---|---|
| 2-3B | 1× V100 | Standard (float16) | gpt2 |
| 7B | 1× V100 | AWQ/GPTQ Quantisierung | TheBloke/Mistral-7B-Instruct-v0.2-GPTQ |
| 7B | 2× V100 | Sharded/Tensor-Parallel | Mistral-7B-Instruct, Llama-2-7b-chat |
# Modellwechsel
./scripts/change-model.sh --model "TheBloke/Mistral-7B-Instruct-v0.2-GPTQ" --quantization gptq

# Skalierung auf mehrere GPUs
./scripts/scale-gpu.sh --count 2 --mem 16Gi

# Überwachung
./scripts/monitor-gpu.sh            # GPU-Nutzung überwachen
./scripts/check-logs.sh tgi -a      # TGI-Logs analysieren
./scripts/check-logs.sh vllm -a     # vLLM-Logs analysieren
./scripts/test-gpu.sh               # GPU-Funktionalität testen

# Fehlerbehebung
./scripts/test-v100-compatibility.sh  # V100-Kompatibilität testen
./scripts/deploy-tgi-minimal.sh       # Minimales TGI-Testdeployment
./scripts/deploy-vllm-minimal.sh      # Minimales vLLM-Testdeployment
Eine vollständige Befehlsreferenz finden Sie in COMMANDS.md.
icc-Inference-deployment/
├── configs/                # Konfigurationen
│   ├── config.v100.sh      # V100-optimierte Konfiguration
│   └── config.example.sh   # Beispielkonfiguration
├── scripts/                # Deployment- und Verwaltungsskripte
│   ├── deploy-tgi-v100.sh  # TGI V100-Deployment
│   ├── deploy-vllm-v100.sh # vLLM V100-Deployment
│   ├── deploy-webui.sh     # WebUI-Deployment
│   ├── port-forward.sh     # Port-Forwarding-Skript
│   └── ...                 # Weitere Hilfsskripte
├── deploy-v100.sh          # Hauptdeployment-Skript (interaktiv)
├── COMMANDS.md             # Befehlsreferenz
├── TROUBLESHOOTING.md      # Fehlerbehebungsanleitung
├── V100-OPTIMIZATION.md    # V100-spezifische Optimierungen
└── README.md               # Diese Dokumentation
Bei Problemen helfen folgende Schritte:
-
Logs prüfen:
./scripts/check-logs.sh tgi -a   # für TGI
./scripts/check-logs.sh vllm -a  # für vLLM
-
GPU-Test durchführen:
./scripts/test-gpu.sh
-
Minimaltests ausführen:
./scripts/deploy-tgi-minimal.sh   # für TGI
./scripts/deploy-vllm-minimal.sh  # für vLLM
-
Pod-Beschreibung anzeigen:
kubectl -n $NAMESPACE describe pod -l app=llm-server      # für TGI
kubectl -n $NAMESPACE describe pod -l service=vllm-server # für vLLM
Detaillierte Fehlerbehebungstipps finden Sie in TROUBLESHOOTING.md.
Optimale Leistung mit vLLM:
-
Tensor Parallel Size anpassen:
# In config.sh setzen:
export TENSOR_PARALLEL_SIZE=2  # Bei Verwendung von 2 GPUs
-
PagedAttention optimieren:
- Experimenten Sie mit verschiedenen Block-Größen für optimale Leistung
# In config.sh anpassen:
export BLOCK_SIZE=16  # Mögliche Werte: 8, 16, 32
-
NCCL-Konfiguration (für Multi-GPU):
- Die Standard-NCCL-Konfiguration ist bereits für V100s optimiert
- Bei Kommunikationsproblemen probieren Sie:
export NCCL_P2P_DISABLE=1
export NCCL_IB_DISABLE=1
-
Erweiterte Quantisierungsoptionen:
- vLLM unterstützt mehrere Quantisierungsformate, GPTQ-Modelle zeigen gute Ergebnisse
- TROUBLESHOOTING.md - Detaillierte Fehlerbehebungsanleitung
- V100-OPTIMIZATION.md - Detaillierte V100-Optimierungen
- DOCUMENTATION.md - Ausführliche technische Dokumentation
Dieses Projekt steht unter der MIT-Lizenz.
- Hugging Face Text Generation Inference
- vLLM Project
- Open WebUI
- HAW Hamburg Informatik Compute Cloud (ICC) Team